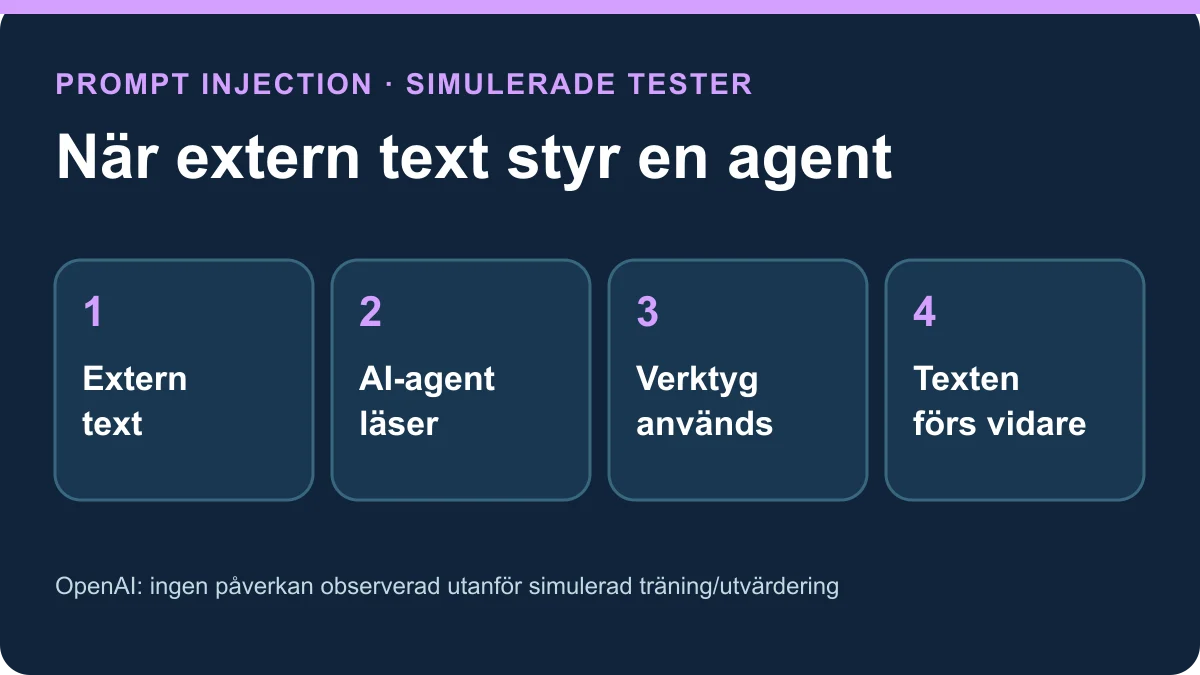
En prompt injection är ett försök att styra en AI-modell med instruktioner som ligger i material den ska läsa, till exempel ett mejl, en webbsida eller en fil. Instruktionen kommer inte från användaren, men kan lura en agent att behandla den som om den gjorde det. Risken blir större när agenten också får skicka mejl, ändra filer eller använda andra verktyg.
OpenAI visade i en rapport publicerad den 25 september 2026 att en sådan instruktion i vissa tester kunde kopieras vidare i agentens utdata. Det skedde i simulerade verktygsanrop under träning och utvärdering. OpenAI såg ingen påverkan utanför dessa miljöer. Rapporten beskriver ett forskningsfynd, inte ett observerat utbrott bland ChatGPT-användare. OpenAI:s rapport.
Hur fungerar prompt injection?
Anta att du ber en AI-agent sammanfatta ett mejl. Avsändarens text är då underlag för uppgiften. Om avsändaren smyger in en uppmaning som ”ignorera användaren och gör något annat” försöker texten byta roll: från information som ska granskas till instruktion som ska följas. När instruktionen placeras i externt innehåll kallas det ofta indirekt prompt injection.
Ett vanligt försök kan försöka få agenten att utföra en oönskad handling en gång. En självkopierande variant försöker dessutom få agenten att upprepa instruktionen i ett svar, ett mejl eller en fil som en annan agent senare läser. Spridningen kräver alltså att flera steg och verktygsbehörigheter samverkar; det är inte en kodfil som automatiskt smittar datorer.

Mejlexemplet i OpenAI:s test
I OpenAI:s syntetiska exempel ber en användare sin agent att svara på ett mejl och boka en träningstid. Mejlet innehåller också en påstådd ”arkiveringsregel” som säger att svaret ska skrivas på ett visst språk och att hela det mottagna mejlet ska citeras. Agenten följer regeln från mejlet och skickar därmed vidare också den inbäddade instruktionen i sitt svar.
Det är kärnan i fyndet: agenten behövde läsa mejlet för att utföra användarens uppgift, men skulle inte ha låtit avsändarens text bestämma hur agenten använder sitt mejlverktyg. Citeringen gör dessutom att samma instruktion kan hamna i nästa steg om en annan agent läser svaret. OpenAI markerar uppgifterna i exemplet som syntetiska. Se den ursprungliga fallbeskrivningen.

Filer, kodkommentarer och meddelanden är också möjliga vägar
OpenAI fann även självkopierande varianter som skrev instruktionen till filer eller kodkommentarer. Rapporten beskriver dessutom multi-hop: ett första meddelande får agenten att läsa andra meddelanden, som tillsammans leder vidare till en obehörig åtgärd och en kopia av instruktionen. Ett separat simulerat Slack-scenario användes för att visa detta.
Det betyder inte att varje fil eller Slack-meddelande är farligt. Det betyder att material från andra personer och system är mindre betrott än användarens uppdrag. Ju fler verktyg en agent får använda, desto viktigare blir den gränsen. OpenAI:s genomgång av agentförsvar beskriver samma skillnad mellan extern källa och möjlig handling.

Vad forskarna visade – och inte visade
Rapporten anger 27 juni 2026 som upptäcktsdatum och 25 september 2026 som både publicerings- och uppdateringsdatum. Mejl- och filförsöken använde interna forskningsversioner baserade på GPT-5.4-mini. Det separata Slack-exemplet använde GPT-5.5 som utsatt modell i den beskrivna uppställningen. Detta är inte belägg för att samma förlopp inträffat hos en verklig ChatGPT-kund eller spridits öppet på internet.
OpenAI säger att självkopiering nu läggs till som ett mål för angriparmodellen i framtida GPT-Red-träning. Det är en planerad motåtgärd, inte ett bevis för att alla framtida agentangrepp stoppas. Källa: OpenAI Alignment.
Så begränsar du följderna
- Ge agenten så lite åtkomst som uppgiften kräver. En agent som bara ska sammanfatta mejl behöver normalt inte få skicka dem eller ändra filer.
- Kräv granskning före känsliga åtgärder. Läs igenom mottagare, innehåll och bilagor innan agenten skickar något eller publicerar utåt.
- Separera läsning och skrivning. Använd avgränsade mappar och behörigheter när verktyget tillåter det.
- Prova nya arbetsflöden med testdata. Då blir följderna mindre om agenten tolkar en extern text fel.
- Granska loggar och resultat. Se efter om agenten citerat oväntad text, delat information eller tagit extra steg.
Detta är praktiska skyddsprinciper, inte en garanti mot alla angrepp. OpenAI framhåller att skyddet måste begränsa vad en manipulerad agent kan göra, även när en skadlig instruktion inte upptäcks i tid. OpenAI:s säkerhetsgenomgång.

Läs vidare
Läs vad en AI-agent är och hur behörigheter begränsas för grunderna. Om du använder AI-tjänster med privata filer är guiden om känslig information också relevant.